Worum es geht
Zwei Versprechen standen am Anfang dieses KI-Zyklus. Erstens: mehr Produktivität. Zweitens: weniger Arbeit. Ein Google-Engineering-Director sagte vor vier Jahren eine Vier-Tage-Woche bis 2025 voraus. OpenAI forderte Anfang 2026 andere Firmen auf, die Vier-Tage-Woche zu testen, bei vollem Gehalt.
Das erste Versprechen wackelt. Das zweite ist kassiert.
Was passiert ist
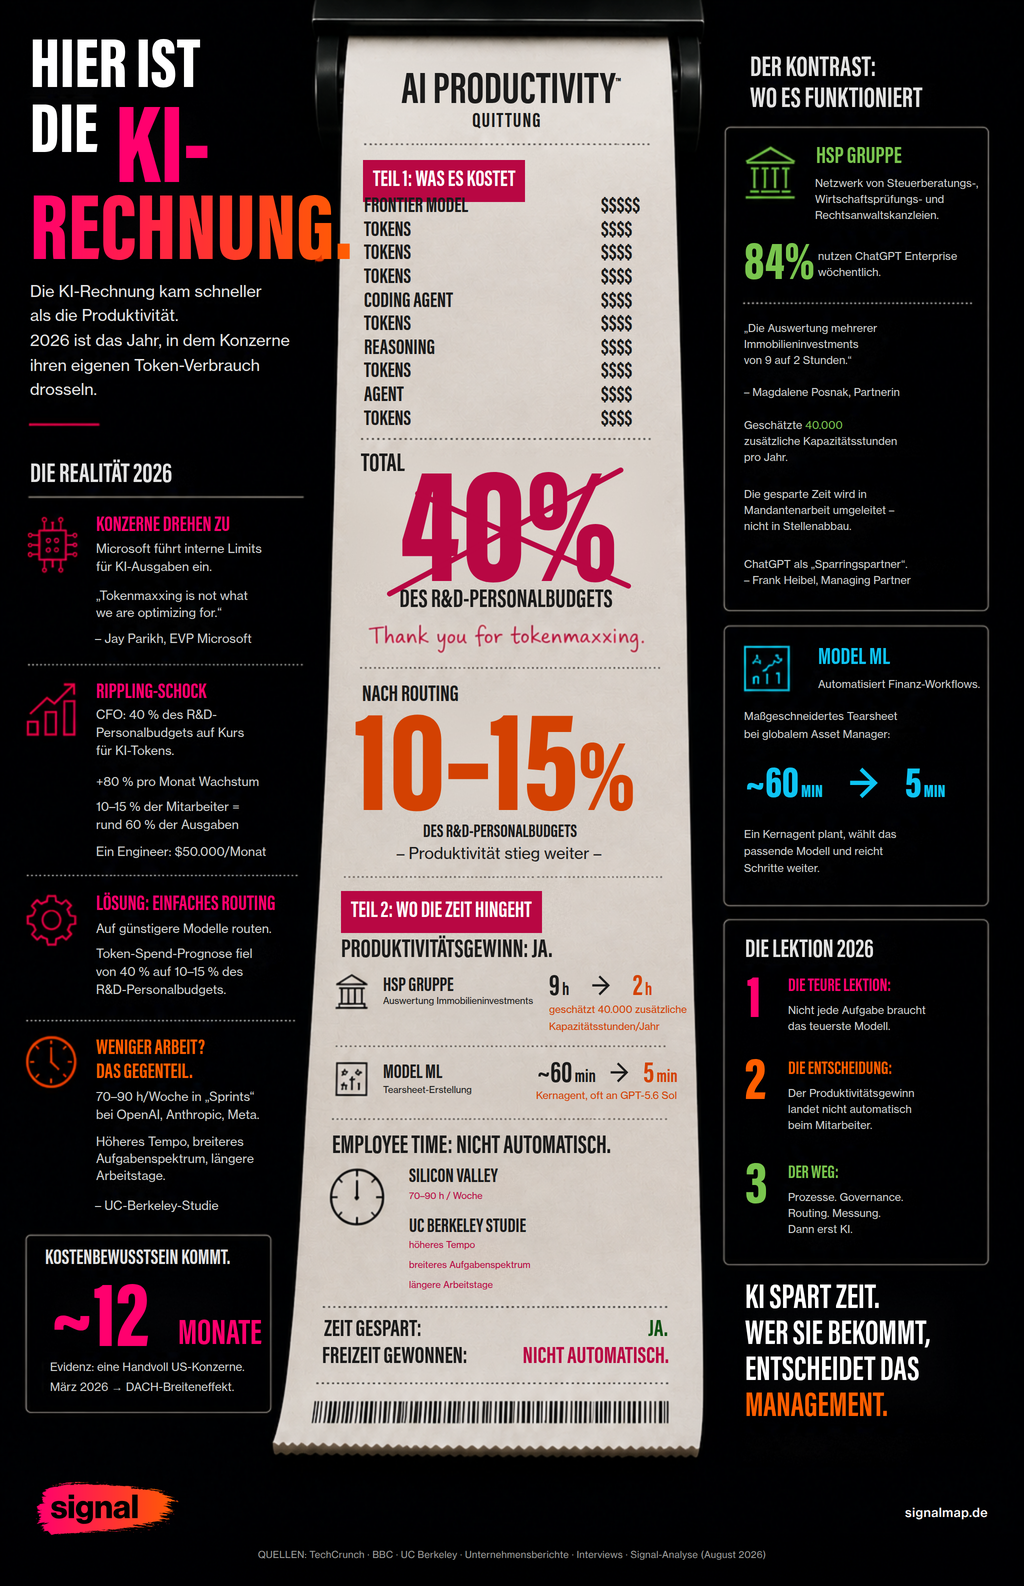
Die Konzerne drehen den eigenen Verbrauch zu. Microsoft hat interne Limits für KI-Ausgaben eingeführt. EVP Jay Parikh an die Belegschaft: „Tokenmaxxing is not what we are optimizing for." GPT-5.6 wird intern zum Standardmodell, weil billiger. Microsoft ist dabei nicht knapp bei Kasse, der letzte Geschäftsbericht schlug die Wall-Street-Erwartungen. Ein anonymer Microsoft-Mitarbeiter bringt es auf den Punkt: Wenn der Betreiber der KI-Infrastruktur die eigenen Produkte drosselt, was heißt das für die Kunden?
Die Zahlen dahinter sind real. Bei Rippling präsentierte CFO Adam Swiecicki im März eine Zahl, die das Führungsteam fassungslos machte, so Chief Product Officer Matt MacInnis gegenüber TechCrunch: Der Konzern war auf Kurs, 40 Prozent des R&D-Personalbudgets für KI-Tokens auszugeben. Wachstum: 80 Prozent Monat für Monat. 10 bis 15 Prozent der Mitarbeiter trieben rund 60 Prozent der Ausgaben, ein einzelner Engineer verbrannte 50.000 Dollar im Monat. Rippling baute daraufhin ein eigenes Werkzeug, das KI-Ausgaben pro Mitarbeiter misst und an tatsächliche Produktivität koppelt. Ergebnis: Die Prognose für den Token-Spend fiel von 40 auf 10 bis 15 Prozent des R&D-Personalbudgets. Die Produktivität stieg laut Rippling weiter, weil die Begrenzung die Engineers klüger machte, nicht weniger leistungsfähig. Der Hebel war schlichtes Routing auf günstigere Modelle.
Weniger Arbeit? Das Gegenteil. Mitarbeiter bei OpenAI, Anthropic und Meta berichten der BBC von 70 bis 90 Stunden pro Woche in „Sprints". Bei Meta wurden Leute per „Drafting" auf KI-Teams verschoben, ohne Wahl. Eine UC-Berkeley-Studie über acht Monate fand: Beschäftigte „arbeiteten in höherem Tempo, übernahmen ein breiteres Aufgabenspektrum und dehnten die Arbeit in mehr Stunden des Tages aus." Neil Thompson (MIT): „Man nimmt an, 20 Prozent weniger Arbeit bedeutet Vier-Tage-Woche. Aber neue Arbeit entsteht."
Die Chefetage sagt es offen. Sam Altman erwartet keine kürzere Woche, Beschäftigte seien „insgeheim" froh, härter zu arbeiten. Meta-CTO Andrew Bosworth wies eine Nachfrage nach mehr Urlaub im Q&A schroff ab und entschuldigte sich später halb. Das gehört zu einer Belegschaft, die dieses Jahr rund 8.000 Entlassungen bei Meta erlebt hat. Über diese Entlassungen und den Druck auf die Beschäftigten machen wir keine Witze.
Der Kontrast: Wo es funktioniert
Zwei Kundenberichte zeigen die andere Seite, mit Zahlen und Namen.
Bei HSP GRUPPE, einem Netzwerk unabhängiger Steuerberatungs-, Wirtschaftsprüfungs- und Rechtsanwaltskanzleien, nutzen 84 Prozent der Belegschaft ChatGPT Enterprise wöchentlich. Partnerin Magdalene Posnak: Die Auswertung mehrerer Immobilieninvestments von neun auf zwei Stunden. Geschätzte 40.000 zusätzliche Kapazitätsstunden pro Jahr. Entscheidend: Die Kanzleien arbeiten bereits an der Kapazitätsgrenze mit Rückständen. Die gesparte Zeit wird in Mandantenarbeit umgeleitet, nicht in Stellenabbau. Managing Partner Frank Heibel nennt ChatGPT einen „Sparringspartner". Die fachliche Endverantwortung bleibt beim Berufsträger.
Bei Model ML, das Finanz-Workflows automatisiert, brauchte ein maßgeschneidertes Tearsheet bei einem globalen Asset Manager statt rund einer Stunde jetzt fünf Minuten. Ein Kernagent plant, wählt das passende Modell und reicht Schritte weiter, oft an GPT-5.6 Sol.
Der Unterschied zwischen HSP und den Silicon-Valley-Belegschaften liegt darin, was mit der gesparten Zeit passiert.
Was das für Deutschland heißt
Der deutsche Mittelstand hat in dieser Debatte einen seltenen Vorteil: Er kommt später dran und kann die Fehler der Frühphase überspringen. Die teure Lektion von Rippling und Microsoft, alle greifen zum teuersten Frontier-Modell für jede Aufgabe, ist bereits dokumentiert. Wer 2026 startet, weiß: mehrere Modelle zu unterschiedlichen Preisen, ein Gateway, das nach Aufgabe routet, und eine Messung, die Ausgaben an Produktivität koppelt. GLM 5.2 leistet laut Rippling-Chef Parker Conrad nahezu dasselbe wie Frontier-Modelle, bei 85 Prozent geringeren Kosten. In denselben Benchmarks, die Rippling für die eigenen internen Anwendungen fuhr, lag Grok insgesamt vorn.
Und die härtere Frage: Der Produktivitätsgewinn ist real, aber er landet nicht automatisch beim Mitarbeiter. Wo er das tut, wie bei HSP, ist es eine bewusste Entscheidung, nicht ein Nebeneffekt der Technik. HSP zeigt das machbare Muster. Die Kanzlei hat zuerst Prozesse und Governance gebaut, dann KI eingeführt, nicht umgekehrt.
Wann kommt das Kostenbewusstsein im DACH-Markt breit an? Rechne mit etwa zwölf Monaten, gemessen am Abstand zwischen den ersten Tokenmaxxing-Rückziehern in den USA (März 2026) und dem typischen Adoptionsverlauf. Evidenz aus einer Handvoll US-Konzerne, das Muster ist aber konsistent.